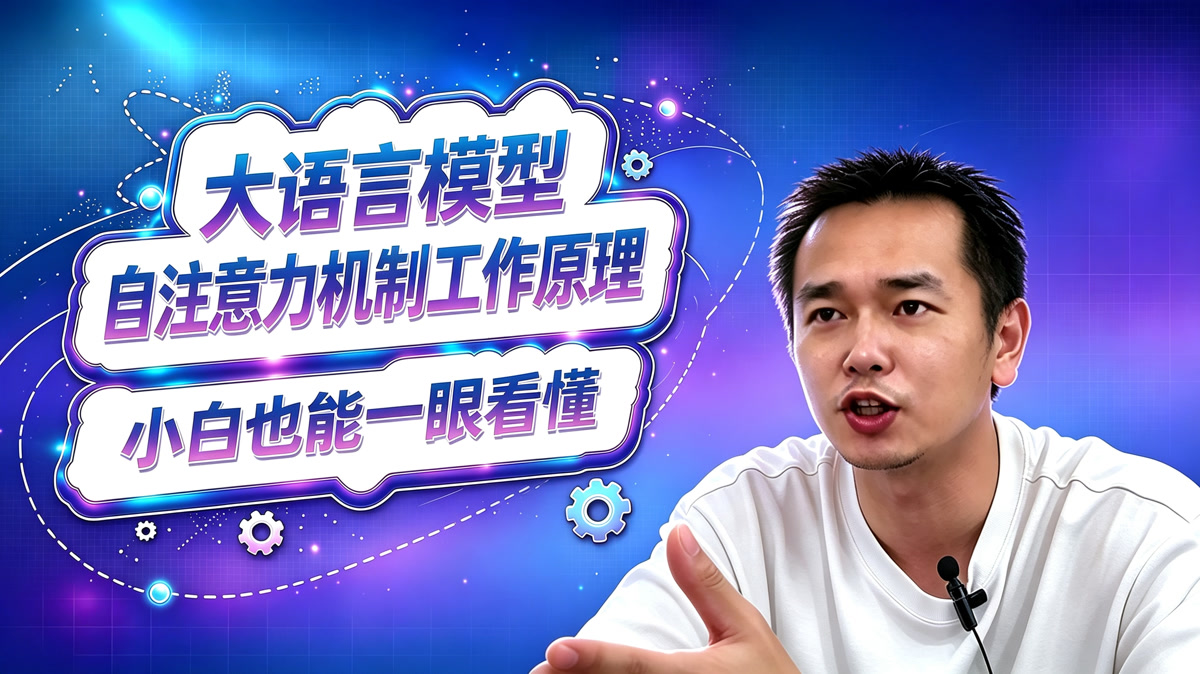
Kun:Deepseek开源桌面版终于来了!直接对标Codex!
DeepSeek推出了开源桌面版应用,直接对标OpenAI Codex和Claude Code。DeepSeek桌面版集成了其强大的大语言模型(DeepSeek V2/V3系列),为开发者提供本地运行的AI编程助手。与需要联网的Cloud IDE不同,DeepSeek桌面版完全本地运行,保护了代码隐私。它在代码理解、生成和调试方面表现出色,支持多种主流编程语言。完全免费开源,是国产AI编程工具的重要里程碑。
相关工具已收录于 AI工具严选

Kun
DeepSeek开源桌面客户端
 微信赞赏
相关推荐

2026-07-20
Deepseek V4 Pro 最新测试!最新benchmarks!
本期带来 Deepseek V4 Pro 最新 benchmark 全面测评,涵盖编程、推理、数学、多模态等核心维度对比。DeepSeek-V4 Pro 是幻方量化推出的高性能大语言模型,采用 MoE 架构,拥有超长上下文处理能力。本期视频通过最新 benchmarks 数据,直观展示 V4 Pro 在各大榜单的表现,与 GPT-4o、Claude 3.5 等头部模型的差距,帮你判断这款国产开源模型是否值得信赖。 访问入口

2025-12-26
Claude Code LSP!DeepSeek可以用吗?
昨天分享了个Claude Code最新的更新,其中有一个是可以使用LSP来快速查找和定位函数等。有朋友问说我后面接的是国内deepseek等大语言模型的话可以用吗?

2026-09-11
Deepseek V4.1 Flash正式版测评!究竟有多能打?
Deepseek V4.1 Flash 正式版实测来了!模型刚上线就惦记着测试,抽时间在 pi 平台开启测评,尽量降低 harness 带来的干扰,思考模式直接拉满开始测试。 推理能力测试 第一题 · 强约束指令句子生成:要求全部句子以「一到十」结尾,通读全部语句都通顺达标。 第二题 · 新版 24 点:要求给出三组解法,结果三组答案全都违规——数字重复使用,不符合「每个数字只能用一次」的硬性规则。 第三题 · 七位数密码锁推理:高难度推理题顺利算出正确答案。 编程项目测评 浏览器操作系统:桌面带有动态动画效果,还有精致小组件,弹窗、Dock 应用运行正常,可惜压轴太空射击游戏无法交互,差了最后一步。 3D 赛车游戏:让人眼前一亮,是这么多轮测评里完成度顶尖的作品,画面精致,车辆模型完整,整体效果非常惊艳。 Trello 看板:采用深色 UI,审美因人而异,卡片拖拽动画效果一般,其余基础功能都正常可用。 整套测试下来,24 点推理题和太空射击项目留下遗憾,但 3D 赛车的代码实现确实足够亮眼。大家怎么看待 Deepseek V4.1 Flash 正式版的这套实测表现...
2026-09-25
Deepseek V4.1 Flash 新版鹈鹕SVG测评报告!
之前有粉丝留言,希望我把 Benchmark 里「鹈鹕骑车」这道题的难度调低之后再重测一遍,这样也能和其他几个模型、包括最近测过的 GPT-6 放在一起横向对比。这一期就来兑现这个承诺。 说起来,这道题原版的提示词确实太难了。后来我专门标注了「转弯的时候动作必须自然平滑,不能出现车身倒立或瞬间闪现掉头」,把难度降了下来,这次就先从 DeepSeek 开始测。开始之前,我们先回顾一下上一次的测评效果。 看结果:这次鹈鹕终于是沿着土星环骑行了,转弯的效果比之前好了很多,整个转弯过程也算比较顺畅。 不过问题还是得说。第一,自行车下方那个很大的「鸡爪」是什么鬼?第二,鹈鹕的翅膀没有扶着车把;第三,鹈鹕的脚跑哪去了?这三个问题在上一次测评里都是没有出现过的,可见 DeepSeek 对这道题的处理确实很不到位。 其余题目没有改动,所以博客上的分数我会继续沿用之前的得分。坦白说,这次总体结果并不比上次好。大家怎么看呢? 访问入口
2026-08-14
Deepseek V4 Pro 重测报告!自家Harnesss上表现如何?
在 DeepSeek Harness 复测 DeepSeek V4 Pro,网上流传模型自家框架专属优化的说法实际效果存疑;拉满 max 思考深度,强约束指令测试结果甚至比 Codex 平台还要差,24 点、密码锁推理作答正确;编程项目中浏览器系统、太空射击游戏表现有所改善,但 3D 赛车滑行 BUG 严重,Trello 看板 UI 与功能依旧出彩,综合来看本次复测整体不及 Codex 上的表现,大概是模型本身存在缺陷…… 访问入口

2026-07-17
Deepseek V4 Pro新架构测评报告!能打吗?
DeepSeek V4 Pro采用了全新的模型架构,本视频对其进行全面的独立测评。新架构在推理效率、上下文长度和知识密度方面都进行了重大优化。通过大量实际测试,评估V4 Pro在编程、数学推理、长文本处理和多轮对话等核心任务上的表现,并与GPT-4、Claude Opus等顶级模型进行对比分析。